Mësimi i pambikëqyrur
Mësimi i pambikëqyrur është një kornizë në mësimin makinerik ku, ndryshe nga mësimi i mbikëqyrur (ang. supervised learning), algoritmet mësojnë modelet vetëm nga të dhënat e paetiketuara.[1] Korniza të tjera brenda spektrit të mbikëqyrjes përfshijnë mbikëqyrjen e dobët ose gjysmë-mbikëqyrjen (ang. weak- or semi-supervision), ku një pjesë e vogël e të dhënave është e etiketuar, si dhe vetë-mbikëqyrjen (self-supervision). Disa studiues e konsiderojnë mësimin e vetë-mbikëqyrur si një formë të mësimit të pambikëqyrur.[2]
Konceptualisht, mësimi i pambikëqyrur ndahet në disa aspekte: të dhënat, trajnimin, algoritmin dhe aplikimet përfundimtare. Zakonisht, të dhënat mblidhen lirshëm "në natyrë", për shembull korpuse të mëdha tekstesh (ang. text corpus) të marra përmes kërkimit në internet (ang. web crawling), me vetëm pak filtrime (si Common Crawl). Kjo krahasohet pozitivisht me mësimin e mbikëqyrur, ku seti i të dhënave (siç është ImageNet1000 ) zakonisht ndërtohet manualisht, gjë që është shumë më e kushtueshme.
Ekzistojnë algoritme të dizajnuara posaçërisht për mësimin e pambikëqyrur, si algoritmet e grupimit (ang. clustering algorithms) të tilla si k-means, teknikat e reduktimit të dimensioneve (ang. dimensionality reduction) si analiza e komponentëve kryesorë (ang. principal component analysis (PCA)), mësimi me makinat Boltzmann dhe autoenkoderët (ang.autoencoders). Pas rritjes së ndikimit të mësuarit të thellë, pjesa më e madhe e mësimit të pambikëqyrur në shkallë të gjerë është kryer duke trajnuar arkitektura të rrjeteve nervore me qëllim të përgjithshëm me anë të zbritjes gradient (ang. gradient descent), të përshtatura për mësim të pambikëqyrur duke dizajnuar një procedurë të përshtatshme trajnimi.
Ndonjëherë një model i trajnuar mund të përdoret ashtu siç është, por më shpesh ai modifikohet për aplikime përfundimtare. Për shembull, metoda e para-trajnimit gjenerues (ang. generative pretraining) e trajnon një model për të gjeneruar një grup të dhënash tekstuale, përpara se të përsoset për aplikime të tjera, si klasifikimi i tekstit.[3][4] Si një shembull tjetër, autoenkoderët trajnohen për të prodhuar tipare të mira (ang. good features), të cilat më pas mund të përdoren si modul për modele të tjera, si për shembull në një model difuzioni latent (ang. latent diffusion model).

Detyrat shpesh kategorizohen si diskriminuese (njohje) ose gjeneruese (imagjinatë). Shpesh, por jo gjithmonë, detyrat diskriminuese përdorin metoda të mbikëqyrura dhe detyrat gjeneruese përdorin metoda të pambikëqyrura (shih diagramin Venn); megjithatë, kjo ndarje është shumë e paqartë. Për shembull, njohja e objekteve zakonisht favorizon mësimin e mbikëqyrur, por mësimi i pambikëqyrur mund t'i grupojë objektet në grupe. Për më tepër, ndërsa progresi ecën përpara, disa detyra përdorin të dyja metodat, dhe disa detyra kalojnë nga njëra në tjetrën. Për shembull, njohja e imazhit filloi si shumë e mbikëqyrur, por u bë hibride duke përdorur para-trajnim të pambikëqyrur, dhe më pas kaloi përsëri drejt mbikëqyrjes me shfaqjen e braktisjes (ang. dropout), ReLU dhe shkallëve të të mësuarit adaptiv (ang. adaptive learning rates).
Një detyrë tipike gjeneruese është si vijon: në çdo hap, merret një pikë e të dhënave si mostër nga grupi i të dhënave, një pjesë e saj hiqet dhe modeli duhet të përfundoj pjesën që është hequr. Kjo është veçanërisht e qartë për autoenkoderët për heqjen e zhurmës (ang. denoising autoencoders) dhe BERT .
Arkitekturat e rrjeteve nervore
Trajnimi
Gjatë fazës së të mësuarit, një rrjet i pambikëqyrur përpiqet të imitojë të dhënat që i jepen dhe përdor gabimin në rezultatin e imituar për t'u korrigjuar vetë (pra, për të korrigjuar peshat dhe paragjykimet e tij). Ndonjëherë gabimi shprehet si një probabilitet i ulët që të ndodhë një rezultat i gabuar, ose mund të shprehet si një gjendje e paqëndrueshme me energji të lartë në rrjet.
Në dallim nga përdorimi dominues i përhapjes prapa (ang.backpropagation nga metodat e mbikëqyrura, të mësuarit pa mbikëqyrje përdor edhe metoda të tjera, duke përfshirë: rregullin e të mësuarit Hopfield, rregullin e të mësuarit Boltzmann, Divergjencën Kontrastuese (ang. Contrastive Divergence), Gjumin e Zgjuar (ang. Wake Sleep), Inferencën Variacionale (ang. Variational Inference), Gjasat Maksimale (ang. Maximum Likelihood), Maximum A Posteriori, Mostrën Gibbs (ang.Gibbs Sampling) .dhe gabimet e rindërtimit të përhapjes prapa ose riparametrimet e gjendjes së fshehur. Shihni tabelën më poshtë për më shumë detaje.
Energjia
Një funksion energjie është një masë makroskopike e gjendjes së aktivizimit të një rrjeti. Tek makinat Boltzmann, ai luan rolin e funksionit të kostos. Kjo analogji me fizikën është frymëzuar nga analiza e Ludwig Boltzmann-it mbi energjisë makroskopike të një gazi nga probabilitetet mikroskopike të lëvizjes së grimcave. , ku k është konstantja e Boltzmannit dhe T është temperatura. Në rrjetin RBM relacioni është , ku dhe ndryshojnë në çdo model të mundshëm aktivizimi dhe Për të qenë më të saktë, , ku është një model aktivizimi i të gjitha neuroneve (të dukshme dhe të fshehura). Për këtë arsye, disa rrjete nervore të hershme mbajnë emrin Makina Boltzmann. Paul Smolensky e quan Harmonia . Një rrjet kërkon energji të ulët e cila është Harmoni e lartë.


Rrjetat
Kjo tabelë tregon diagramet e lidhjes së rrjeteve të ndryshme të pambikëqyrura, detajet e të cilave do të jepen në seksionin Krahasimi i Rrjeteve. Rrathët janë neurone dhe skajet midis tyre janë peshat e lidhjes. Ndërsa ndryshon dizajni i rrjetit, shtohen veçori për të mundësuar aftësi të reja ose hiqen për ta bërë të mësuarit më të shpejtë. Për shembull, neuronet ndryshojnë midis deterministikës (Hopfield) dhe stokastike (Boltzmann) për të mundësuar një dalje të fuqishme, peshat hiqen brenda një shtrese (RBM) për të shpejtuar të mësuarit, ose lidhjet lejohen të bëhen asimetrike (Helmholtz).
| Hopfield | Boltzmann | RBM | Boltzmann i grumbulluar |
|---|---|---|---|
 |
 |
 |
 |
| Helmholc | Autoenkoder | VAE |
|---|---|---|
 |
 |
 |
Nga rrjetet që mbanin emrat e njerëzve, vetëm Hopfield ka punuar drejtpërdrejt me rrjetet nervore. Boltzmann dhe Helmholtz ishin para rrjeteve nervore artificiale, por puna e tyre në fizikë dhe fiziologji frymëzoi metodat analitike që u përdorën.
Historia
| 1974 | Modeli magnetik i Ising i propozuar nga WA Little për njohjen |
| 1980 | Kunihiko Fukushima prezanton neokognitronin (ang. neocognitron), i cili më vonë quhet rrjet nervor konvolucional (ang. convolutional neural network ). Përdoret kryesisht në SL, por meriton të përmendet këtu. |
| 1982 | Varianti i rrjetit Hopfield të Ising-ut i përshkruar si CAM dhe klasifikues nga John Hopfield. |
| 1983 | Varianti i makinës Boltzmann të Ising me neurone probabilistike të përshkruara nga Hinton & Sejnowski pas punës së Sherington & Kirkpatrick të vitit 1975. |
| 1986 | Paul Smolensky boton Teorinë e Harmonisë, e cila është një RBM me praktikisht të njëjtin funksion energjie Boltzmann. Smolensky nuk dha një skemë trajnimi praktik. Hinton e bëri në mesin e viteve 2000. |
| 1995 | Hochreiter dhe Schmidhuber prezantojnë neuronin LSTM për gjuhët. |
| 1995 | Dayan & Hinton prezanton makinën Helmholtz |
| 2013 | Kingma, Rezende dhe bashkë. prezantuan Autoenkoduesit Variacionalë si rrjet grafik probabiliteti Bayesian, me rrjeta nervore si komponentë. |
Rrjete specifike
Këtu, ne theksojmë disa karakteristika të rrjeteve të zgjedhura. Detajet e secilit prej tyre jepen në tabelën krahasuese më poshtë.
Rrjeti Hopfield (ang.Hopfield Network) Ferromagnetizmi frymëzoi rrjetet Hopfield. Një neuron korrespondon me një domen hekuri me momente magnetike binare Lart dhe Poshtë, dhe lidhjet nervore korrespondojnë me ndikimin e një domeni mbi tjetrin. Lidhjet simetrike mundësojnë një formulim global të energjisë. Gjatë inferencës, rrjeti përditëson çdo gjendje duke përdorur funksionin standard të aktivizimit. Peshat simetrike dhe funksionet e duhura të energjisë garantojnë konvergjencë drejt një modeli stabil aktivizimi. Peshat asimetrike janë të vështira për t'u analizuar.Rrjetet Hopfield përdoren si Kujtesa të Aksesueshme me Përmbajtje (ang. Content Addressable Memories (CAM)). Makina Boltzmann (ang. Boltzmann Machine) Këto janë rrjete Hopfield stokastike. Vlera e gjendjes së tzre merret nga ky funksion densiteti probabiliteti (ang. probability density function (pdf)) në këtë mënyrë: supozojme që një neuron binar aktivizohet me probabilitetin Bernoulli p(1) = 1/3 dhe pushon me p(0) = 2/3. Një vlerë merret duke zgjedhur një numër rastësor y të shpërndarë në mënyrë uniforme dhe duke e futur në funksionin e shpërndarjes kumulative të anuluar (ang. cumulative distribution function), që në këtë rast është funksioni i aktivizimit me prag 2/3. Funksioni i anuluar = { 0 nëse x <= 2/3, 1 nëse x > 2/3 }.
Rrjeti i Besimit Sigmoid (ang. Sigmoid Belief Net) E prezantuar nga Radford Neal në 1992, ky rrjet aplikon ide nga modelet grafike probabilistike tek rrjetet nervore. Një dallim kyç është se nyjet në modelet grafike kanë kuptime të paracaktuara, ndërsa veçoritë e neuronëve të Belief Net përcaktohen pas trajnimit. Rrjeti është një graf i drejtuar aciklik me lidhje të rralla, i përbërë nga neuronë binarë stokastikë. Rregulli i të nxënit vjen nga Likelihood Maksimal mbi p(X): Δwij ∝ sj * (si – pi), ku pi = 1 / (1 + e^(peshat e inputeve në neuronin i)). Sj-të janë aktivizime nga një mostër e paanshme e shpërndarjes pasuese dhe kjo është problematike për shkak të problemit 'Explaining Away' të ngritur nga Judea Pearl. Metodat Variacionale Bayesiane (ang. Variational Bayesian methods) përdorin një shpërndarje pasuese zëvendësuese dhe injorojnë në mënyrë të dukshme këtë kompleksitet.
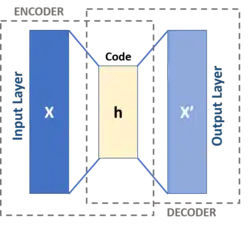
Rrjeti i Besimit të Thellë (ang. Deep Belief Network) E prezantuar nga Hinton, ky rrjet është një hibride e RBM-së dhe Rrjetit të Besimit Sigmoid. Dy shtresat e sipërme janë një RBM, ndërsa shtresa e dytë dhe më poshtë formojnë një rrjet besimi sigmoid. Ai trajnohet me metodën e RBM-ve të grumbulluara dhe pastaj hiqen peshat e njohjes poshtë RBM-së së sipërme. Që nga viti 2009, duket se 3-4 shtresa janë thellësia optimale. Makina Helmholtz (ang. Helmholtz machine) Këto janë frymëzime të hershme për Variational Auto Encoders. Dy rrjetet e tij janë të kombinuara në një – peshat përpara kryejnë njohjen dhe peshat mbrapa implementojnë imagjinatën. Ai është ndoshta rrjeti i parë që bën të dyja. Helmholtz nuk ka punuar në mësimin e makinerive, por ai frymëzoi konceptin e një "motori inferencash statistikore që funksionon për të nxjerrë shkaqet e mundshme të inputeve sensory". Neuroni binar stokastik jep një probabilitet që gjendja e tij të jetë 0 ose 1. Inputi i të dhënave zakonisht nuk konsiderohet një shtresë, por në modalitetin e gjenerimit të Helmholtz machine, shtresa e të dhënave merr input nga shtresa e mesme dhe ka peshat e veçanta për këtë qëllim, kështu që konsiderohet një shtresë. Prandaj ky rrjet ka tre shtresa. Autoenkoder variacional (ang. Variational autoencoder) Këto janë të frymëzuara nga Helmholtz machines dhe kombinojnë rrjetet probabilistike me rrjetet nervore. Një Autoencoder është një rrjet CAM me tre shtresa, ku shtresa e mesme supozohet të jetë një përfaqësim i brendshëm i modeleve të inputit. Rrjeti nervor i encoder-it është një shpërndarje probabilistike qφ(z dhënë x), dhe rrjeti i decoder-it është pθ(x dhënë z). Peshat quhen phi dhe theta në vend të W dhe V si tek Helmholtz, një ndryshim thjesht kozmetik. Këto dy rrjete mund të jenë plotësisht të lidhura ose të përdorin një skemë tjetër rrjeti nervor.
| Hopfield | Boltzmann | RBM | RBM i grumbulluar | Helmholc | Autoenkoder | VAE | |
|---|---|---|---|---|---|---|---|
| Përdorimi dhe të dhënat e shquara | CAM, problemi i shitësit udhëtues | CAM. Liria e lidhjeve e bën këtë rrjet të vështirë për t'u analizuar. | njohje modelesh. përdoret në shifrat dhe të folurit MNIST. | njohje dhe imagjinatë. të trajnuara me para-trajnim të pambikëqyrur dhe/ose akordim të imët të mbikëqyrur. | imagjinatë, mimikë | gjuhë: shkrim krijues, përkthim. vizion: përmirësim i imazheve të turbullta | gjeneron të dhëna realiste |
| Neuron | gjendje binare deterministe. Aktivizimi = { 0 (ose -1) nëse x është negativ, 1 përndryshe } | neuroni binar stokastik Hopfield | ← e njëjta. (e zgjeruar në vlerë reale në mesin e viteve 2000) | ← e njëjta | ← e njëjta | gjuha: LSTM. shikimi: fushat receptive lokale. zakonisht aktivizimi reluksoz me vlerë reale. | Neuronet e shtresës së mesme kodojnë mesataret dhe variancat për Gausianët. Në modalitetin e ekzekutimit (inferencë), rezultati i shtresës së mesme janë vlera të marra si mostra nga Gausianët. |
| Lidhjet | 1-shtrese me pesha simetrike. Pa vetë-lidhje. | 2-shtresa. 1-e fshehur dhe 1-e dukshme. pesha simetrike. | ← e njëjta gjë. pa lidhje anësore brenda një shtrese. |
Shtresa e sipërme është e padrejtuar, simetrike. Shtresat e tjera janë dykahëshe, asimetrike. | 3-shtresa: pesha asimetrike. 2 rrjete të kombinuara në 1. | 3-shtresa. Hyrja konsiderohet një shtresë edhe pse nuk ka pesha hyrëse. Shtresa përsëritëse për NLP. Përdredhje të përparme për shikimin. Hyrja dhe dalja kanë të njëjtin numër neuronesh. | 3-shtresa: hyrje, kodues, shpërndarje, dekoder. Mostrat nuk konsiderohen si shtresë. |
| Përfundimi dhe energjia | Energjia jepet nga masa e probabilitetit të Gibbsit : | ← e njëjta | ← e njëjta | minimizoni divergjencën e KL-së | Përfundimi është vetëm feed-forward. Rrjetet e mëparshme UL kanë ecur përpara DHE prapa. | gabimi i minimizimit = gabimi i rindërtimit – KLD | |
| Trajnim | Δw ij = s i *s j, për +1/-1 neuron | Δw ij = e*(p ij – p' ij ). Kjo rrjedh nga minimizimi i KLD. e = shkalla e të nxënit, p' = parashikohet dhe p = shpërndarja aktuale. | Δw ij = e*( < v i h j > të dhëna - < v i h j > ekuilibër ). Kjo është një formë e divergjencës kontrastive me mostrën Gibbs. "<>" janë pritjet. | ← ngjashëm. tren 1-shtrese në të njëjtën kohë. gjendje e përafërt ekuilibri me një kalim me 3 segmente. pa përhapje prapa. | trajnim 2-fazor zgjim-gjumje | përhap prapa gabimin e rindërtimit | riparametrizon gjendjen e fshehur për prapavijën |
| Forca | i ngjan sistemeve fizike, kështu që trashëgon ekuacionet e tyre | ← e njëjta gjë. Neuronet e fshehura veprojnë si përfaqësime të brendshme të botës së jashtme | skemë trajnimi më e shpejtë dhe më praktike sesa makinat Boltzmann | stërvitet shpejt. jep një shtresë hierarkike të veçorive | pak anatomik. i analizueshëm me teori informacioni dhe mekanikë statistikore | ||
| Dobësi | e vështirë për t’u stërvitur për shkak të lidhjeve anësore | Ekuilibri kërkon shumë përsëritje | Neuronet me numra të plotë dhe me vlerë reale janë më të ndërlikuara. |

Mësimi Hebbian, ART, SOM
Shembulli klasik i mësimit të pambikëqyrur në studimin e rrjeteve nervore është parimi i Donald Hebb, domethënë, neuronet që aktivizohen së bashku lidhen së bashku. Në mësimin Hebbian (ang. Hebbian learning), lidhja përforcohet pavarësisht nga ndonjë gabim, por është ekskluzivisht një funksion i rastësisë midis potencialeve të veprimit midis dy neuroneve. Një version i ngjashëm që modifikon peshat sinaptike merr në parasysh kohën midis potencialeve të veprimit ( plasticiteti i varur nga koha e kulmit (ang. spike-timing-dependent plasticity) ose STDP). Mësimi Hebbian është hipotezuar se qëndron në themel të një sërë funksionesh njohëse, të tilla si njohja e modelit (ang. pattern recognition) dhe të mësuarit nga përvoja.
Ndër modelet e rrjeteve nervore (ang. neutral network), harta vetëorganizuese (ang. self-organizing map SOM) dhe teoria e rezonancës adaptive (ang. adaptive resonance theory ART) përdoren zakonisht në algoritmet e mësimit të pambikëqyrur. SOM është një organizim topografik në të cilin vendndodhjet e afërta në hartë përfaqësojnë të dhëna hyrëse me veti të ngjashme. Modeli ART lejon që numri i grupeve të ndryshojë me madhësinë e problemit dhe i lejon përdoruesit të kontrollojë shkallën e ngjashmërisë midis anëtarëve të të njëjtave grupe me anë të një konstante të përcaktuar nga përdoruesi të quajtur parametri i vigjilencës. Rrjetet ART përdoren për shumë detyra të njohjes së modelit, të tilla si njohja automatike e objektivit (ang. automatic target recognition) dhe përpunimi i sinjalit sizmik.
Metodat probabilistike
Dy nga metodat kryesore të përdorura në të mësimin e pambikëqyrur janë analiza e komponentëve kryesorë (ang. principal component) dhe analiza e grupimeve (ang. cluster analysis). Analiza e grupimeve përdoret në mësimin e pambikëqyrur për të grupuar ose segmentuar grupe të dhënash me tipare të përbashkëta në mënyrë që të ekstrapolohen marrëdhëniet algoritmike. Analiza e grupimeve është një degë e të mësuarit automatik që grupon të dhënat që nuk janë etiketuar (ang. labelled), klasifikuar ose kategorizuar. Në vend që t'i përgjigjet reagimeve, analiza e grupimeve identifikon ngjashmëritë në të dhëna dhe vepron bazuar në praninë ose mungesën e ngjashmërive të tilla në çdo pjesë të re të të dhënave. Kjo qasje ndihmon në zbulimin e pikave të të dhënave anomale që nuk përshtaten në asnjërin grup.
Një aplikim qendror i të mësimit të pambikëqyrur është në fushën e vlerësimit të dendësisë (ang. density estimation)në statistikë, megjithëse mësimi i pambikëqyrur përfshin shumë fusha të tjera që lidhen me përmbledhjen dhe shpjegimin e karakteristikave të të dhënave. Ai mund të krahasohet me të mësimin e mbikëqyrur duke thënë se ndërsa mësimi i mbikëqyrur synon të nxjerrë një shpërndarje të probabilitetit të kushtëzuar (ang. conditional probability distribution) bazuar në etiketën e të dhënave hyrëse, mësimi i pambikëqyrur synon të nxjerrë një shpërndarje të probabilitetit a priori (ang. a priori probability).
Qasja
Disa nga algoritmet më të zakonshme të përdorura në mësimin e pambikëqyrur përfshijnë: (1) Grumbullimin, (2) Zbulimin e anomalive, (3) Qasjet për të mësuar modelet e variablave latente. Çdo qasje përdor disa metoda si më poshtë:
- Metodat e grupimit (ang. clustering) përfshijnë: grupimin hierarkik (ang. hierarchial clustering), k-means, modelet e përzierjes (ang. mixture models), grupimin e bazuar në model (ang. model-based clustering), DBSCAN dhe algoritmin OPTICS (ang. OPTICS algorithm)
- Metodat e zbulimit të anomalive (ang. anomaly detection) përfshijnë: Faktorin Lokal të Jashtëzakonshëm (ang. Local Outlier Factor) dhe Pyllin e Izolimit (ang. Isolation Forest)
- Qasje për të mësuar modelet e variablave latente (ang. latent variable models) siç janë algoritmi i maksimizimit të pritjes (ang. Expectation-maximization algorithm EM), metoda e momenteve (ang. method of moments) dhe teknikat e ndarjes së sinjalit të verbër (ang. blind signal separaation) (analiza e komponentëve kryesorë, analiza e komponentëve të pavarur (ang. independent component analysis), faktorizimi i matricës jo-negative (ang. non-negative matrix), dekompozimi i vlerës singulare (ang. singular value decomposition) )
Metoda e momenteve
Një nga qasjet statistikore për mësimin e pambikëqyrur është metoda e momenteve (ang. method of moments). Në metodën e momenteve, parametrat e panjohur (të interesit) në model lidhen me momentet e një ose më shumë variablave të rastësishme, dhe kështu, këta parametra të panjohur mund të vlerësohen duke pasur parasysh momentet. Momentet zakonisht vlerësohen nga mostrat empirikisht. Momentet bazë janë momentet e rendit të parë dhe të dytë. Për një vektor rastësor, momenti i rendit të parë është vektori mesatar (ang. mean), dhe momenti i rendit të dytë është matrica e kovariancës (ang. covariance matrix) (kur mesatarja është zero). Momentet e rendit më të lartë zakonisht përfaqësohen duke përdorur tenzorë të cilët janë përgjithësimi i matricave në rend më të lartë si vargje shumëdimensionale.
Në veçanti, metoda e momenteve tregohet të jetë efektive në mësimin e parametrave të modeleve të variablave latente (ang. latent variable models). Modelet e variablave latente janë modele statistikore ku përveç variablave të vëzhguara, ekziston edhe një grup variablash latente që nuk vëzhgohen. Një shembull shumë praktik i modeleve të variablave latente në të mësuarit makinerik është modelimi i temave (ang. topic modeling), i cili është një model statistikor për gjenerimin e fjalëve (variablat e vëzhguara) në dokument bazuar në temën (variablin latente) të dokumentit. Në modelimin e temave, fjalët në dokument gjenerohen sipas parametrave të ndryshëm statistikorë kur tema e dokumentit ndryshohet. Tregohet se metoda e momenteve (teknikat e dekompozimit të tensorit) rikuperon vazhdimisht parametrat e një klase të madhe modelesh të variablave latente nën disa supozime.
Algoritmi i maksimizimit të pritjes (ang. expectation-maximization algorithm EM) është gjithashtu një nga metodat më praktike për të mësuar modelet e variablave latente. Megjithatë, ai mund të ngecë në optimumet lokale dhe nuk është e garantuar që algoritmi do të konvergojë te parametrat e vërtetë të panjohur të modelit. Në të kundërt, për metodën e momenteve, konvergjenca globale është e garantuar në disa kushte.
Shiko edhe
- Mësim automatik i makinës (ang. Automated machine learning)
- Analiza e klasterit (ang. Cluster analysis)
- Grumbullimi i bazuar në model (ang. Model-based clustering)
- Zbulimi i anomalive (ang. Anomaly detection)
- Algoritmi i maksimizimit të pritjes (ang. Expectation-maximization algorithm)
- Hartë topografike gjenerative (ang. Generative topographic map)
- Meta-mësim (shkencë kompjuterike) (ang. Meta-learning (computer science))
- Analiza shumëvariabël (ang. Multivariate analysis)
- Rrjeti i funksioneve bazë radiale (ang. Radial basis function network)
- Mbikëqyrje e dobët (ang. Weak supervision)
Referime
- ↑ Wu, Wei. "Unsupervised Learning" (PDF) (në anglisht). Arkivuar (PDF) nga origjinali më 14 prill 2024. Marrë më 26 prill 2024.
- ↑ Liu, Xiao; Zhang, Fanjin; Hou, Zhenyu; Mian, Li; Wang, Zhaoyu; Zhang, Jing; Tang, Jie (2021). "Self-supervised Learning: Generative or Contrastive". IEEE Transactions on Knowledge and Data Engineering (në anglisht): 1. arXiv:2006.08218. doi:10.1109/TKDE.2021.3090866. ISSN 1041-4347.
- ↑ Radford, Alec; Narasimhan, Karthik; Salimans, Tim; Sutskever, Ilya (11 qershor 2018). "Improving Language Understanding by Generative Pre-Training" (PDF) (në anglisht). OpenAI. fq. 12. Arkivuar (PDF) nga origjinali më 26 janar 2021. Marrë më 23 janar 2021.
- ↑ Li, Zhuohan; Wallace, Eric; Shen, Sheng; Lin, Kevin; Keutzer, Kurt; Klein, Dan; Gonzalez, Joey (2020-11-21). "Train Big, Then Compress: Rethinking Model Size for Efficient Training and Inference of Transformers". Proceedings of the 37th International Conference on Machine Learning (në anglisht). PMLR: 5958–5968.
- Roman, Victor (2019-04-21). "Unsupervised Machine Learning: Clustering Analysis". Medium (në anglisht). Arkivuar nga origjinali më 2020-08-21. Marrë më 2019-10-01.
- Jordan, Michael I.; Bishop, Christopher M. (2004). "7. Intelligent Systems §Neural Networks". përmbledhur nga Tucker, Allen B. (red.). Computer Science Handbook (në anglisht) (bot. 2nd). Chapman & Hall/CRC Press. doi:10.1201/9780203494455. ISBN 1-58488-360-X. Arkivuar nga origjinali më 2022-11-03. Marrë më 2022-11-03.
- Hastie, Tibshirani & Friedman 2009, fq. 485–586
- Garbade, Dr Michael J. (2018-09-12). "Understanding K-means Clustering in Machine Learning". Medium (në anglisht). Arkivuar nga origjinali më 2019-05-28. Marrë më 2019-10-31.
- Anandkumar, Animashree; Ge, Rong; Hsu, Daniel; Kakade, Sham; Telgarsky, Matus (2014). "Tensor Decompositions for Learning Latent Variable Models" (PDF). Journal of Machine Learning Research (në anglisht). 15: 2773–2832. arXiv:1210.7559. Bibcode:2012arXiv1210.7559A. Arkivuar (PDF) nga origjinali më 2015-03-20. Marrë më 2015-04-10.
- Buhmann, J.; Kuhnel, H. (1992). "Unsupervised and supervised data clustering with competitive neural networks". [Proceedings 1992] IJCNN International Joint Conference on Neural Networks (në anglisht). Vëll. 4. IEEE. fq. 796–801. doi:10.1109/ijcnn.1992.227220. ISBN 0-7803-0559-0. S2CID 62651220.
- Comesaña-Campos, Alberto; Bouza-Rodríguez, José Benito (qershor 2016). "An application of Hebbian learning in the design process decision-making". Journal of Intelligent Manufacturing (në anglisht). 27 (3): 487–506. doi:10.1007/s10845-014-0881-z. ISSN 0956-5515. S2CID 207171436.
- Carpenter, G.A.; Grossberg, S. (1988). "The ART of adaptive pattern recognition by a self-organizing neural network" (PDF). Computer (në anglisht). 21 (3): 77–88. doi:10.1109/2.33. S2CID 14625094. Arkivuar nga origjinali (PDF) më 2018-05-16. Marrë më 2013-09-16.
- Hinton, G. (2012). "A Practical Guide to Training Restricted Boltzmann Machines" (PDF). Neural Networks: Tricks of the Trade. Lecture Notes in Computer Science (në anglisht). Vëll. 7700. Springer. fq. 599–619. doi:10.1007/978-3-642-35289-8_32. ISBN 978-3-642-35289-8. Arkivuar (PDF) nga origjinali më 2022-09-03. Marrë më 2022-11-03.
- "Deep Belief Nets" (video) (në anglisht). shtator 2009. Arkivuar nga origjinali më 2022-03-08. Marrë më 2022-03-27.
<ref> etiketa me emrin "tds-ul" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "JordanBishop2004" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "Hastie" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "tds-kmeans" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "TensorLVMs" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "Buhmann" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "Comesana" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "Carpenter" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "Hinton2010" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Gabim citimi:
<ref> etiketa me emrin "HintonMlss2009" e percaktuar ne <referenca> nuk është përdorur në tekst paraprak.Lexime të mëtejshme
- Bousquet, O.; von Luxburg, U.; Raetsch, G., red. (2004). Advanced Lectures on Machine Learning (në anglisht). Springer. ISBN 978-3-540-23122-6.
- Duda, Richard O.; Hart, Peter E.; Stork, David G. (2001). "Unsupervised Learning and Clustering". Pattern classification (në anglisht) (bot. 2nd). Wiley. ISBN 0-471-05669-3.
- Hastie, Trevor; Tibshirani, Robert; Friedman, Jerome (2009). "Unsupervised Learning". The Elements of Statistical Learning: Data Mining, Inference, and Prediction (në anglisht). Springer. fq. 485–586. doi:10.1007/978-0-387-84858-7_14. ISBN 978-0-387-84857-0. Arkivuar nga origjinali më 2022-11-03. Marrë më 2022-11-03.
- Hinton, Geoffrey; Sejnowski, Terrence J., red. (1999). Unsupervised Learning: Foundations of Neural Computation (në anglisht). MIT Press. ISBN 0-262-58168-X.