Contrastive Language-Image Pre-training
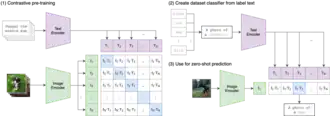 | |
| Тип | vision-language modeld[1] і програмне забезпечення  |
|---|---|
| Розробник | OpenAI |
| Перший випуск | 5 січня 2021 |
| Мова програмування | Python |
| Ліцензія | MIT License |
| Репозиторій | github.com/OpenAI/CLIP |
| Вебсайт | openai.com/research/clip |
Contrastive Language-Image Pre-training (CLIP) — це метод навчання пари моделей нейронних мереж, одна з яких призначена для розуміння зображень, а інша — для розуміння тексту, з використанням контрастової цільової функції.[2] Цей метод уможливив широке застосування в багатьох галузях, включаючи кросмодальний пошук,[3] генерацію зображень за текстом,[4] та естетичне ранжування.[5]
Алгоритм
Метод CLIP навчає пару моделей контрастово.[2] Одна модель приймає фрагмент тексту як вхідні дані та видає один вектор, що представляє його семантичний зміст. Інша модель приймає зображення і аналогічно видає один вектор, що представляє його візуальний зміст. Моделі навчаються так, щоб вектори, що відповідають семантично схожим парам текст-зображення, були розташовані близько один до одного у спільному векторному просторі, тоді як вектори несхожих пар знаходилися далеко один від одного.[2]
Для навчання пари моделей CLIP спочатку готують великий набір даних пар зображення-підпис. Під час навчання моделям пред'являються батчі з пар зображення-підпис. Нехай вихідні дані текстової та візуальної моделей будуть відповідно . Два вектори вважаються «схожими», якщо вони мають великий скалярний добуток.


Функція втрат на даному батчі, — це багатокласові N-парні втрати (англ. multi-class N-pair loss),[6] які являють собою симетричні втрати крос-ентропії над оцінками схожості:

По суті, ця функція втрат стимулює збільшення скалярного добутку між відповідними векторами зображення та тексту (), водночас перешкоджаючи високим значенням скалярного добутку для невідповідних пар. Параметр — це температура, яка в оригінальній моделі CLIP параметризується як , де є навчальним параметром.


Можливі й інші функції втрат. Наприклад, Sigmoid CLIP (SigLIP)[7] пропонує наступну функцію втрат:

де — це від'ємна логарифмічна сигмоїдна функція втрат, а символ дельти Дірака дорівнює 1, якщо , і 0 в іншому випадку.


Моделі CLIP
Хоча оригінальна модель була розроблена компанією OpenAI, згодом моделі навчали й інші організації.
Модель зображень

Моделі кодування зображень, що використовуються в CLIP, зазвичай є візуальними трансформерами (ViT). Схема найменування цих моделей часто відображає конкретну архітектуру ViT. Наприклад, «ViT-L/14» означає «vision transformer large» (великий візуальний трансформер порівняно з іншими моделями тієї ж серії) з розміром патча 14, що означає, що перед обробкою трансформером зображення розділяється на патчі розміром 14 на 14 пікселів. Показники розміру варіюються від B, L, H, G (base, large, huge, giant) у вказаному порядку.
Окрім ViT, візуальною моделлю зазвичай є згорткова нейронна мережа, така як ResNet (в оригінальній серії OpenAI) або ConvNeXt[8] (у серії моделей OpenCLIP від LAION[9]).
Оскільки вихідні вектори моделі зображень і текстової моделі повинні мати однакову довжину, обидві моделі мають вектори виходу фіксованої довжини, що в оригінальному звіті називається «розмірністю вкладення» (англ. embedding dimension).
Наприклад в моделях ResNet розмірності вкладень варіюються від 512 до 1024,[10]: а для ViTs, від 512 до 768.[10]:
| Назва | Роздільна здатність | Параметрів (загалом, мільйонів) | Параметри (зір) | Параметри (текст) | Розмірність вкладення | Розмір (MB) | Дата випуску |
|---|---|---|---|---|---|---|---|
| RN50 | 224 | 102 | 38.3 | 63.1 | 1024 | 244 | 2021-01 |
| RN101 | 224 | 120 | 56.3 | 63.1 | 512 | 278 | 2021-03 |
| RN50x4 | 288 | 178 | 87.1 | 90.7 | 640 | 402 | 2021-03 |
| RN50x16 | 384 | 291 | 167.3 | 123.0 | 768 | 630 | 2021-07 |
| RN50x64 | 448 | 623 | 420.4 | 201.8 | 1024 | 1260 | 2022-01 |
| ViT-B/32 | 224 | 151 | 87.8 | 63.1 | 512 | 338 | 2021-01 |
| ViT-B/16 | 224 | 150 | 86.2 | 63.1 | 512 | 335 | 2021-07 |
| ViT-L/14 | 224 | 428 | 304.0 | 123.0 | 768 | 890 | 2022-01 |
| ViT-L/14@336px | 336 | 428 | 304.3 | 123.0 | 768 | 891 | 2022-04 |
Коментарі
- ↑
!pip install git+https://github.com/openai/CLIP.git
!wget https://github.com/openai/CLIP/raw/main/CLIP.png -O CLIP.png

import torch
import clip
from PIL import Image
import numpy as np

device = "cuda" if torch.cuda.is_available() else "cpu"
for m in clip.available_models():
    model, preprocess = clip.load(m, device=device)

    input_resolution = model.visual.input_resolution
    context_length = model.context_length
    vocab_size = model.vocab_size

    print("Model parameters:", f"{np.sum([int(np.prod(p.shape)) for p in model.parameters()]):,}")
    print("Input resolution:", input_resolution)
    print("Context length:", context_length)
    print("Vocab size:", vocab_size)

    n_params_vision = sum(p.numel() for p in model.visual.parameters())
    n_params_text = sum(p.numel() for p in model.transformer.parameters())
    image = preprocess(Image.open("CLIP.png")).unsqueeze(0).to(device)
    image_features = model.encode_image(image)
    print(f"Model: {m}, #vision parameters: {n_params_vision:,}, #text parameters: {n_params_text:,}, embedding dimension: {image_features.shape[1]}")
    del model, preprocess, image, image_features
Примітки
- ↑ а б A Dive into Vision-Language Models — Hugging Face.
- ↑ а б в Radford, Alec; Kim, Jong Wook; Hallacy, Chris; Ramesh, Aditya; Goh, Gabriel; Agarwal, Sandhini; Sastry, Girish; Askell, Amanda; Mishkin, Pamela; Clark, Jack; Krueger, Gretchen; Sutskever, Ilya (1 липня 2021). Learning Transferable Visual Models From Natural Language Supervision. Proceedings of the 38th International Conference on Machine Learning. PMLR. с. 8748—8763.
- ↑ Hendriksen, Mariya; Bleeker, Maurits; Vakulenko, Svitlana; van Noord, Nanne; Kuiper, Ernst; de Rijke, Maarten (2022). Extending CLIP for Category-to-Image Retrieval in E-Commerce. У Hagen, Matthias; Verberne, Suzan; Macdonald, Craig; Seifert, Christin; Balog, Krisztian; Nørvåg, Kjetil; Setty, Vinay (ред.). Advances in Information Retrieval. Lecture Notes in Computer Science (англ.). Т. 13185. Cham: Springer International Publishing. с. 289—303. doi:10.1007/978-3-030-99736-6_20. ISBN 978-3-030-99736-6.
- ↑ Stable Diffusion Repository on GitHub. CompVis - Machine Vision and Learning Research Group, LMU Munich. 17 вересня 2022. Архів оригіналу за 18 січня 2023. Процитовано 17 вересня 2022.
- ↑ LAION-AI/aesthetic-predictor, LAION AI, 6 вересня 2024, процитовано 8 вересня 2024
- ↑ Sohn, Kihyuk (2016). Improved Deep Metric Learning with Multi-class N-pair Loss Objective. Advances in Neural Information Processing Systems. Curran Associates, Inc. 29.
- ↑ Zhai, Xiaohua; Mustafa, Basil; Kolesnikov, Alexander; Beyer, Lucas (2023). Sigmoid Loss for Language Image Pre-Training. IEEE/CVF International Conference on Computer Vision (ICCV). с. 11975—11986.
- ↑ Liu, Zhuang; Mao, Hanzi; Wu, Chao-Yuan; Feichtenhofer, Christoph; Darrell, Trevor; Xie, Saining (2022). A ConvNet for the 2020s. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). с. 11976—11986.
- ↑ Ilharco, Gabriel; Wortsman, Mitchell; Wightman, Ross; Gordon, Cade; Carlini, Nicholas; Taori, Rohan; Dave, Achal; Shankar, Vaishaal; Namkoong, Hongseok (Липень 2021), OpenCLIP, Zenodo, Bibcode:2021zndo...5143773I, doi:10.5281/zenodo.5143773, процитовано 6 вересня 2024
- ↑ а б Radford, Alec; Kim, Jong Wook; Hallacy, Chris; Ramesh, Aditya; Goh, Gabriel; Agarwal, Sandhini; Sastry, Girish; Askell, Amanda; Mishkin, Pamela; Clark, Jack; Krueger, Gretchen; Sutskever, Ilya (2021). Learning Transferable Visual Models From Natural Language Supervision. arXiv:2103.00020 [cs.CV].
{{cite arXiv}}:|arxiv=є обов'язковим параметром (довідка) - ↑ openai/CLIP, OpenAI, 6 вересня 2024, процитовано 6 вересня 2024