Analiza e algoritmeve

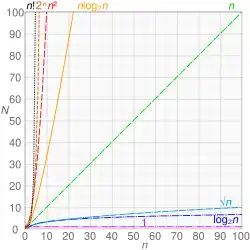
Në shkencën kompjuterike, analiza e algoritmeve është procesi i gjetjes së kompleksitetit llogaritës të algoritmeve - sasia e kohës, hapësirës së ruajtjes ose burimeve të tjera të nevojshme për t'i ekzekutuar ato. Kjo zakonisht përfshin përcaktimin e një funksioni që lidh madhësinë e të dhënave hyrëse të një algoritmi me numrin e hapave që ndërmerr (kompleksi i tij kohor) ose numrin e vendeve të hapësirave se ruajtjes që përdor (kompleksi i tij hapësinor). Një algoritëm konsiderohet efikas kur vlerat e këtij funksioni janë të vogla ose rriten ngadalë teksa rritet madhësia e të dhënave hyrëse. Të dhënat hyrëse të ndryshme me të njëjtën madhësi mund të shkaktojnë që algoritmi të sillet ndryshe, kështu që përshkrimet e rastit më të mirë, më të keq dhe atij mesatar mund të jenë të gjitha me interes praktik. Kur nuk specifikohet ndryshe, funksioni që përshkruan performancën e një algoritmi zakonisht paraqet një kufi të sipërm, i përcaktuar nga rastet më të këqija të të dhënave hyrëse për algoritmin.
Termi "analiza e algoritmeve" u shpik nga Donald Knuth.[1] Analiza e algoritmeve është një pjesë e rëndësishme e teorisë më të gjerë të kompleksitetit kompjuterik, e cila ofron vlerësime teorike për burimet që i nevojiten çdo algoritmi që zgjidh një problem të caktuar kompjuterik. Këto vlerësime ofrojnë një pasqyrë mbi drejtimet e arsyeshme të kërkimit për algoritme efikase .
Në analizën teorike të algoritmeve, është e zakonshme që kompleksiteti i tyre të vlerësohet në kuptimin asimptotik, d.m.th., të vlerësohet funksioni i kompleksitetit për të dhëna hyrëse arbitrarisht të mëdha (pa limit te caktuar). Për këtë qëllim përdoren shënimi Big O, shënimi Big-omega si dhe shënimi Big-theta.[2] Për shembull, thuhet se kërkimi binar kryhet në një numër proporcional hapash me logaritmin e madhësisë n të listës së renditur që kërkohet, ose në O(log n), qe zakonisht quhet "kohë logaritmike". Zakonisht përdoren vlerësime asimptotike, sepse zbatime të ndryshme të të njëjtit algoritëm mund të ndryshojnë në efikasitet. Megjithatë, efikasitetet e çdo dy zbatimeve "të arsyeshme" të një algoritmi të caktuar lidhen me një faktor shumëzues konstant, i quajtur konstante e fshehur .
Masat e sakta (jo asimptotike) të efikasitetit nganjëherë mund të llogariten, por zakonisht ato kërkojnë supozime të caktuara në lidhje me zbatimin e veçantë të algoritmit, të cilat quhen model i llogaritjes. Një model llogaritjeje mund të përkufizohet në terma të një kompjuteri abstrakt, p.sh. makina Turing, dhe/ose duke supozuar që disa operacione ekzekutohen në kohë njësi. Për shembull, nëse lista e renditur mbi të cilën zbatojmë kërkimin binar ka n elementë, dhe ne mund të garantojmë që çdo kërkim i një elementi në listë kryhet brenda një njësie kohe, atëherë nevojiten maksimumi log2(n) + 1 njësi kohore për të kthyer një përgjigje.
Modelet e kostos
Vlerësimet e efikasitetit kohor varen nga ajo që ne e përcaktojmë si një hap.Që analiza të përputhet me kohën reale të ekzekutimit, çdo hap duhet të kryhet brenda një kohe të kufizuar nga një konstante. Duhet të jemi të kujdesshëm këtu; për shembull, disa analiza e konsiderojnë mbledhjen e dy numrave si një hap të vetëm. Ky supozim mund të mos jetë i vlefshëm në disa kontekste të caktuara. Për shembull, nëse numrat e përfshirë në një llogaritje mund të jenë arbitrarisht të mëdhenj, koha që kërkohet për një mbledhje të vetme nuk mund të supozohet më të jetë konstante (nuk mund të themi më se një mbledhje kërkon gjithmonë të njëjtën kohë).
Zakonisht përdoren dy modele kostoje:[3][4][5][6][7]
- modeli i kostos uniforme, i quajtur edhe modeli i kostos për njësi (dhe variante të ngjashme), i përcakton një kosto të njëjtë çdo operacioni të makinës, pavarësisht nga madhësia e numrave të përfshirë.
- modeli logaritmik i kostos, i quajtur edhe matje logaritmike e kostos (dhe variante të ngjashme), i cakton çdo operacioni të makinës një kosto të përshtatshme me numrin e bitëve të përfshirë.
Kjo e fundit është më e vështirë për t’u përdorur, prandaj përdoret vetëm kur është e nevojshme, për shembull në analizën e algoritmeve të aritmetikës me saktësi arbitrare, si ato që përdoren në kriptografi.
Një pikë kyçe që shpesh anashkalohet është se kufijtë e poshtëm të publikuar për probleme të caktuara jepen shpesh për një model llogaritjeje më të kufizuar se sa bashkësia e operacioneve që mund të përdoren në praktikë; për këtë arsye, ekzistojnë algoritme që janë më të shpejtë se ç’do të mendohej fillimisht.[8]
Analiza e kohës së ekzekutimit
Analiza e kohës së ekzekutimit është një klasifikim teorik që vlerëson dhe parashikon rritjen e kohës së ekzekutimit të një algoritmi përgjatë së cilës madhësia e të dhënave hyrëse (zakonisht e shënuar me n) rritet. Efikasiteti i kohës së ekzekutimit është një temë me interes të madh në shkencën kompjuterike: një program mund të zgjasë sekonda, orë, ose edhe vite për të përfunduar ekzekutimin, në varësi të algoritmit që përdor. Ndërsa teknikat e profilizimit të softuerit mund të përdoren për të matur kohën e ekzekutimit të një algoritmi në praktikë, ato nuk mund të ofrojnë të dhëna kohore për të gjitha inputet e mundshme (në numër të pafund); këtë mund ta bëjnë vetëm metodat teorike të analizës së kohës së ekzekutimit.
Mangësitë e metrikave empirike
Meqenëse algoritmet janë të pavarura nga platforma (domethënë një algoritëm i caktuar mund të zbatohet në çdo gjuhe e programimit, në çdo kompjuter dhe në çdo sistem operativ), përdorimi i një qasjeje empirike për të vlerësuar performancën krahasuese të një grupi të caktuar algoritmesh (kur përdorim metoda praktike (empirike) për të krahasuar algoritme) vërejmë edhe disa të meta të tjera.
Merrni si shembull një program që kërkon një hyrje specifike në një listë të renditur me madhësi n. Supozoni se ky program është ekzekutuar në Kompjuteri A, një makinë moderne e teknologjisë së fundit, duke përdorur një algoritëm kërkimi linear, dhe në Kompjuterin B, një makinë shumë më e ngadaltë, duke përdorur një algoritëm kërkimi binar. Testimi krahasues (benchmark) në dy kompjuterët që ekzekutojnë programet e tyre përkatëse mund të duket diçka si më poshtë:
| n (madhësia e listës) | Kompjuteri A në kohën e ekzekutimit (në nanosekonda) |
Koha e ekzekutimit të kompjuterit B (në nanosekonda) |
|---|---|---|
| 16 | 8 | 100,000 |
| 63 | 32 | 150,000 |
| 250 | 125 | 200,000 |
| 1,000 | 500 | 250,000 |
Bazuar në këto matje, do të ishte e lehtë të arrijmë në përfundimin se Kompjuteri A po ekzekuton një algoritëm që është shumë më efikas sesa ai i Kompjuterit B. Megjithatë, nëse madhësia e listës së të dhënave hyrëse rritet në një numër të mjaftueshëm, ky përfundim është qartas i gabuar, pra rezulton në një gabim teknik te kompjuterit A:
| n (madhësia e listës) | Kompjuteri A në kohën e ekzekutimit (në nanosekonda) |
Koha e ekzekutimit të kompjuterit B (në nanosekonda) |
|---|---|---|
| 16 | 8 | 100,000 |
| 63 | 32 | 150,000 |
| 250 | 125 | 200,000 |
| 1,000 | 500 | 250,000 |
| ... | ... | ... |
| 1,000,000 | 500,000 | 500,000 |
| 4,000,000 | 2,000,000 | 550,000 |
| 16,000,000 | 8,000,000 | 600,000 |
| ... | ... | ... |
| 63,072 × 10 12 | 31,536 × 10 12 ns,
ose 1 vit |
1,375,000 ns, ose 1.375 milisekonda |
Kompjuteri A, që ekzekuton programin e kërkimit linear, shfaq një shkallë rritjeje lineare. Koha e ekzekutimit të programit është proporcionale me madhësinë e të dhënave hyrëse. Dyfishimi i madhësisë së të dhënave hyrëse dyfishon kohën e ekzekutimit, katërfishimi i madhësisë së të dhënave hyrëse katërfishon kohën e ekzekutimit e kështu me radhë. Nga ana tjetër, Kompjuteri B, që ekzekuton programin e kërkimit binar, shfaq një shkallë rritjeje logaritmike. Katërfishimi i madhësisë së të dhënave hyrëse e rrit kohën e ekzekutimit vetëm me një sasi konstante (në këtë shembull, 50,000 ns). Edhe pse Kompjuteri A është, në dukje, një makinë më e shpejtë, Kompjuteri B do ta tejkalojë pashmangshëm Kompjuterin A në kohën e ekzekutimit, sepse po përdor një algoritëm me një shkallë rritjeje shumë më të ngadaltë.
Renditjet e rritjes
Në mënyrë joformale, thuhet se një algoritëm ka një shkallë rritjeje të rendit të një funksioni matematik (pra rritet sipas një funksioni të caktuar), nëse pas një madhësie të caktuar të hyrjes n, funksioni f(n) i shumëzuar me një konstante pozitive jep një kufi të sipërm për kohën e ekzekutimit të atij algoritmi. Me fjalë të tjera, për një madhësi hyrëse n që është më e madhe se një vlerë e caktuar n0 dhe për një konstante c, koha e ekzekutimit të atij algoritmi nuk do ta kalojë kurrë vlerën c × f(n). Ky koncept zakonisht shprehet me notacionin Big O. Për shembull, pasi koha e ekzekutimit të algoritmit të renditjes me insertim rritet në mënyrë kuadratike kur rritet madhësia e hyrjes, thuhet se renditja me insertim është e rendit O(n2).
Notacioni Big O është një mënyrë e përshtatshme për të përshkruar skenarin më të keq të një algoritmi, megjithëse mund të përdoret edhe për të treguar rastin mesatar. Për shembull, skenari më i keq për algoritmin e renditjes së shpejtë (quicksort) është O(n2), ndërsa koha mesatare e ekzekutimit është O(n log n).
Rendet empirike të rritjes
Duke supozuar se koha e ekzekutimit ndjek rregullin e fuqisë, t ≈ kna, parametri a mund të gjendet[9] duke marrë matje empirike të kohës së ekzekutimit t1 dhe t2 në disa pika të madhësisë së problemit n1 dhe n2, dhe duke zgjidhur ekuacionin t2/t1 = (n2/n1)a në raport me a, që domethënë, a = log(t2/t1)/log(n2/n1). Me fjalë të tjera, kjo mat pjerrësinë e vijës empirike. në një pikë të caktuar, në grafikun log–log që tregon kohën e ekzekutimit kundrejt madhësisë hyrëse. Nëse rendi i rritjes vërtet ndjek rregullin e fuqisë (dhe prandaj vija në grafikun log–log është e drejtë), atëherë vlera empirike e a mbetet konstante në zona të ndryshme. Në të kundërt, a ndryshon (dhe vija bëhet e lakuar). por megjithatë, kjo metodë mund të përdoret për të krahasuar rendin lokal të rritjes së dy algoritmeve të caktuar. E aplikuar në tabelën e mëposhtme:
| n (madhësia e listës) | Kompjuteri A në kohën e ekzekutimit (në nanosekonda) |
Rendi lokal i rritjes (n^_) |
Koha e ekzekutimit të kompjuterit B (në nanosekonda) |
Rendi lokal i rritjes (n^_) |
|---|---|---|---|---|
| 15 | 7 | 100,000 | ||
| 65 | 32 | 1.04 | 150,000 | 0.28 |
| 250 | 125 | 1.01 | 200,000 | 0.21 |
| 1,000 | 500 | 1.00 | 250,000 | 0.16 |
| ... | ... | ... | ||
| 1,000,000 | 500,000 | 1.00 | 500,000 | 0.10 |
| 4,000,000 | 2,000,000 | 1.00 | 550,000 | 0.07 |
| 16,000,000 | 8,000,000 | 1.00 | 600,000 | 0.06 |
| ... | ... | ... |
Shihet qartë se algoritmi i parë ka rritje lineare, siç pritet nga rregulli i fuqisë. Ndërsa vlerat empirike për algoritmin e dytë bien shpejt, duke treguar se ai ndjek një ritëm tjetër rritjeje dhe, në çdo rast, ka rritje lokale më të ulët (madje edhe në përmirësim) krahasuar me të parin.
Vlerësimi i kompleksitetit në kohë ekzekutimi
Kompleksiteti i kohës së ekzekutimit për skenarin më të keq të një algoritmi të caktuar mund të vlerësohet ndonjëherë duke analizuar strukturën e algoritmit dhe duke bërë disa supozime thjeshtuese. Merrni parasysh pseudokodin e mëposhtëm:
1 // marr një numër të plotë pozitiv n nga hyrja
2 nëse n > 10
3         shtyp "Kjo mund të zgjasë pak..."
4   për i = 1 deri në n
5     për j = 1 deri në i
6                shtyp i * j
7 shtyp "U krye!"
Një kompjuter i caktuar do të marrë një sasi të caktuar (diskrete) kohe për të ekzekutuar secilën nga udhëzimet e përfshira në këtë algoritëm. Le të supozojmë se veprimet e kryera në hapin 1 marrin në maksimum kohën T1, hapi 2 merr në maksimum kohën T2, e kështu me radhë.
Në algoritmin e mësipërm, hapat 1, 2 dhe 7 ekzekutohen vetëm një herë. Për një vlerësim të rastit më të keq, duhet supozuar se edhe hapi 3 ekzekutohet. Prandaj, koha totale për ekzekutimin e hapave 1–3 dhe hapit 7 është:

Lakoret (ciklet) në hapat 4, 5 dhe 6 janë më të vështira për t’u vlerësuar. Testi i lakores së jashtme në hapin 4 do të ekzekutohet (n + 1) herë,[10] gjë që konsumon kohë T4(n + 1). Lakorja e brendshme, nga ana tjetër, varet nga vlera e j, e cila përsëritet nga 1 deri në i. Në kalimin e parë të lakores së jashtme, j shkon nga 1 në 1: lakorja e brendshme kryen një përsëritje, prandaj ekzekutimi i trupit të lakores së brendshme (hapi 6) konsumon kohë T6 dhe testi i lakores së brendshme (hapi 5) konsumon 2T5.
Në kalimin e dytë të lakores së jashtme, j shkon nga 1 në 2: lakorja e brendshme kryen dy përsëritje, kështu që trupi i lakores së brendshme (hapi 6) konsumon 2T6 dhe testi i lakores së brendshme (hapi 5) konsumon 3T5.
Në tërësi, koha totale e nevojshme për të ekzekutuar trupin e lakores së brendshme mund të shprehet si një progresioni aritmetik:

e cila mund të faktorizohet[11] si

Koha totale e nevojshme për të ekzekutuar testin e ciklit të brendshëm mund të vlerësohet në mënyrë të ngjashme:

e cila mund të faktorizohet si

Prandaj, koha totale e ekzekutimit për këtë algoritëm është:

e cila reduktohet në

Si rregull praktik, mund të supozohet se termi i rendit më të lartë në një funksion të caktuar dominon shkallën e rritjes së tij dhe për rrjedhojë përcakton rendin e tij të ekzekutimit. Në këtë shembull, n2 është termi i rendit më të lartë, ndaj mund të konkludohet se f(n) = O(n2). Formalisht, kjo mund të vërtetohet si më poshtë:
Vërteto se
Le te jetë k një konstante më e madhe ose e barabartë me [T1..T7]
Rrjedhimisht


Një qasje më elegante për të analizuar këtë algoritëm do të ishte të supozohej se [T1..T7] janë të gjitha të barabarta me një njësi kohe, në një sistem njësish të zgjedhur në mënyrë që kjo njësi të jetë më e madhe ose e barabartë me kohët reale të këtyre hapave. Kjo do të nënkuptonte që koha e ekzekutimit të algoritmit shpërndahet si më poshtë:[12]

Analiza e shkallës së rritjes së burimeve të tjera
Metodologjia e analizës së kohës së ekzekutimit mund të përdoret gjithashtu për të parashikuar shkallë të tjera rritjeje, si p.sh. konsumin e hapësirës së memories. Si shembull, merrni parasysh pseudokodin e mëposhtëm, i cili menaxhon dhe rialokon përdorimin e memories nga një program, bazuar në madhësinë e një skedari që ai program administron:
ndërsa skedari është ende i hapur:
  le të jetë n = madhësia e skedarit
  për çdo 100,000 kilobajt rritje në madhësinë e skedarit
    dyfishi i sasisë së memories së rezervuar
Në këtë rast, ndërsa madhësia e skedarit n rritet, memoria do të konsumohet me një shkallë rritjeje eksponenciale, e cila është e rendit O(2n). Kjo përfaqëson një shkallë rritjeje jashtëzakonisht të shpejtë dhe, me shumë gjasë, të pakontrollueshme për konsumin e burimeve të memories.
Rëndësia
Analiza e algoritmeve është e rëndësishme në praktikë, sepse përdorimi aksidental ose i paqëllimshëm i një algoritmi joefikas mund të ndikojë ndjeshëm në performancën e sistemit. Në aplikacionet e ndjeshme ndaj kohës, një algoritëm që kërkon shumë kohë për t’u ekzekutuar mund t’i bëjë rezultatet e tij të vjetruara ose të padobishme. Një algoritëm joefikas mund të kërkojë gjithashtu sasi joekonomike të fuqisë llogaritëse ose hapësirës së ruajtjes për të funksionuar, duke e bërë atë praktikisht të papërdorshëm.
Faktorë konstantë
Analiza e algoritmeve zakonisht përqendrohet te performanca asimptotike, veçanërisht në nivel elementar, por në zbatime praktike faktorët konstantë janë të rëndësishëm dhe të dhënat reale janë gjithmonë të kufizuara në madhësi. Kufiri zakonisht përcaktohet nga madhësia e memories së adresueshme, kështu që në makinat 32-bit, 232 = 4 GiB (më e madhe nëse përdoret memorie e segmentuar), dhe në makinat 64-bit, 264 = 16 EiB. Prandaj, duke qenë se madhësia e të dhënave është e kufizuar, një rend rritjeje (në kohë ose hapësirë) mund të reduktohet në një faktor konstant dhe, në këtë kuptim, të gjithë algoritmet praktikë janë O(1) për një konstante mjaftueshëm të madhe ose për madhësi të dhënash mjaftueshëm të vogla.
Ky interpretim është kryesisht i dobishëm për funksionet që rriten jashtëzakonisht ngadalë. Për shembull: logaritmi i iteruar binar (log*) është më pak se 5 për të gjitha të dhënat praktike (deri në 265536 bit); log-log-u binar (og log n) është më pak se 6 për pothuajse të gjitha të dhënat praktike (deri në 264 bit); dhe logaritmi binar (log n) është më pak se 64 për pothuajse të gjitha të dhënat praktike (deri në 264 bit). Një algoritëm me kompleksitet jo-konstant mund të jetë megjithatë më efikas në praktikë sesa një algoritëm me kompleksitet konstant, nëse mbingarkesa e këtij të fundit rezulton në një faktor konstant më të madh. Për shembull, mund të ndodhë që për sa kohë që dhe .


Për të dhëna të mëdha, faktorët linearë ose kuadratikë nuk mund të injorohen, por për të dhëna të vogla një algoritëm asimptotikisht joefikas mund të jetë më i shpejtë. Kjo përdoret veçanërisht në algoritmet hibride, si Timsort, të cilat përdorin një algoritëm asimptotikisht efikas (këtu merge sort, me kompleksitet kohor ), por kalojnë te një algoritëm asimptotikisht joefikas (këtu renditja me insertim, me kompleksitet kohor ) për të dhëna të vogla, pasi algoritmi më i thjeshtë është më i shpejtë për madhësi të vogla të dhënash.


Shiko edhe
Shënime
Referime
- Sedgewick, Robert; Flajolet, Philippe (2013). An Introduction to the Analysis of Algorithms (në anglisht) (bot. 2nd). Addison-Wesley. ISBN 978-0-321-90575-8.
- Greene, Daniel A.; Knuth, Donald E. (1982). Mathematics for the Analysis of Algorithms (në anglisht) (bot. Second). Birkhäuser. ISBN 3-7643-3102-X.
- Cormen, Thomas H.; Leiserson, Charles E.; Rivest, Ronald L. & Stein, Clifford (2001). Introduction to Algorithms (në anglisht). Chapter 1: Foundations (bot. Second). Cambridge, MA: MIT Press and McGraw-Hill. fq. 3–122. ISBN 0-262-03293-7.
- Sedgewick, Robert (1998). Algorithms in C, Parts 1-4: Fundamentals, Data Structures, Sorting, Searching (në anglisht) (bot. 3rd). Reading, MA: Addison-Wesley Professional. ISBN 978-0-201-31452-6.
- Knuth, Donald. The Art of Computer Programming (në anglisht). Addison-Wesley.
- Goldreich, Oded (2010). Computational Complexity: A Conceptual Perspective (në anglisht). Cambridge University Press. ISBN 978-0-521-88473-0.
Lidhje të jashtme
Stampa:Computer science
- ↑ "Knuth: Recent News" (në anglisht). 28 gusht 2016. Arkivuar nga origjinali më 28 gusht 2016.
- ↑ Cormen, Thomas H. (2009). Introduction to algorithms (në anglisht) (bot. 3rd). Cambridge, Mass: MIT Press. fq. 44–52. ISBN 978-0-262-03384-8.
- ↑ Alfred V. Aho; John E. Hopcroft; Jeffrey D. Ullman (1974). The design and analysis of computer algorithms (në anglisht). Addison-Wesley Pub. Co. ISBN 9780201000290., section 1.3
- ↑ Juraj Hromkovič (2004). Theoretical computer science: introduction to Automata, computability, complexity, algorithmics, randomization, communication, and cryptography (në anglisht). Springer. fq. 177–178. ISBN 978-3-540-14015-3.
- ↑ Giorgio Ausiello (1999). Complexity and approximation: combinatorial optimization problems and their approximability properties (në anglisht). Springer. fq. 3–8. ISBN 978-3-540-65431-5.
- ↑ Wegener, Ingo (2005), Complexity theory: exploring the limits of efficient algorithms, Berlin, New York: Springer-Verlag, p. 20, ISBN 978-3-540-21045-0
- ↑ Tarjan, Robert Endre (1983). Data structures and network algorithms (në anglisht). SIAM. fq. 3–7. ISBN 978-0-89871-187-5.
- ↑ "Examples of the price of abstraction?". Theoretical Computer Science Stack Exchange (në anglisht). Marrë më 2025-12-09.
- ↑ Lipton, Richard J. (2017-03-08). "How To Avoid O-Abuse and Bribes". Gödel’s Lost Letter and P=NP (në anglisht). Arkivuar nga origjinali më 2017-03-08. Marrë më 2025-12-09.
- ↑ Një hap shtesë kërkohet për të përfunduar for-loop-in, prandaj ekzekutohen n + 1 dhe jo n herë.
- ↑ mund te vertetohet me induksion se.
- ↑ Kjo qasje, ndryshe nga ajo më sipër, injoron kohën konstante të testimit të lakoreve, por është e thjeshtë të tregohet se kjo nuk ndikon në rezultatin final
